KI-Halluzinationen: Ursachen und Lösungen für Unternehmen

Als KI-Halluzination bezeichnet man eine Ausgabe eines Sprachmodells, die sprachlich flüssig und überzeugend formuliert ist, inhaltlich aber falsch, frei erfunden oder nicht durch die vorliegenden Quellen gedeckt ist. Das Modell erfindet dabei Fakten, Zahlen, Quellen oder Zusammenhänge, ohne seine Unsicherheit erkennbar zu machen.
Eine Kundin fragt den KI-Chatbot ihres Mobilfunkanbieters nach ihrer Kündigungsfrist. Die Antwort kommt sofort und klingt kompetent: drei Monate zum Monatsende. In ihrem Vertrag steht etwas anderes. Der Agent hat die Frist nicht nachgeschlagen, er hat sie aus Wahrscheinlichkeiten zusammengesetzt.
So sieht eine KI-Halluzination aus. Die Gründe dafür liegen teils im Modell selbst, teils in der Art, wie es eingesetzt wird. Auf den zweiten Teil haben Unternehmen direkten Einfluss, und mit den richtigen Stellschrauben nennt dein KI-Chatbot auf dieselbe Frage die Frist, die wirklich im Vertrag steht.
Warum halluzinieren KI-Modelle?
KI-Modelle halluzinieren, weil sie wahrscheinliche Wortfolgen berechnen, ohne Fakten zu prüfen. Verstärkt wird das durch Lücken in den Trainingsdaten, durch Trainingsverfahren, die Raten belohnen, und durch fehlenden Kontext in der Anwendung.


Ursachen im Modell
1. Plausibilität statt Wahrheit
Sprachmodelle sagen vorher, welches Wort am wahrscheinlichsten als Nächstes kommt. Ob die Aussage stimmt, prüfen sie dabei nicht. Laut einer Studie von OpenAI und Georgia Tech (Kalai et al., 2025) entstehen dadurch selbst mit fehlerfreien Trainingsdaten zwangsläufig Fehler, vor allem bei Einzelfakten, die im Training nur selten vorkommen.
2. Raten wird belohnt
Dieselbe Studie beschreibt ein zweites Problem. Die meisten Benchmarks bewerten KI-Modelle wie eine Prüfung ohne Minuspunkte. Ein Modell, das bei Unsicherheit rät, schneidet besser ab als eines, das „Ich weiß es nicht“ sagt.
3. Fehlerhafte oder veraltete Daten
Was falsch oder überholt im Trainingsmaterial steht, kann das Modell wiedergeben. Zudem kennen Modelle nur Informationen bis zu einem bestimmten Stichtag und füllen Lücken zu neueren Entwicklungen im Zweifel mit Vermutungen.
4. Post-Training mit neuem Wissen
Neue Fakten, die ein Modell erst im Post-Training kennenlernt, nimmt es nur langsam auf. Gekhman et al. (2024) von Google Research und der israelischen Technischen Universität Technion haben zudem beobachtet, dass ein Modell sein vorhandenes Wissen umso schlechter abruft und umso häufiger halluziniert, je mehr dieser neuen Fakten es tatsächlich verinnerlicht.
5. Fehlaktivierung im Modell
Forschungsergebnisse von Anthropic 2025 deuten darauf hin, dass zumindest das untersuchte Modell (Claude 3.5 Haiku) bei Unwissen eigentlich zur Zurückhaltung neigt. Erkennt es jedoch einen Namen, ohne zusätzliche Fakten über diese Person zu kennen, kann diese Zurückhaltung fälschlich ausgeschaltet werden. Das Modell erfindet dann eine plausible Antwort.
Ursachen in der Anwendung
1. Vage Prompts
Bei einer unklar oder mehrdeutig formulierten Frage muss das Modell raten, was gemeint ist, und füllt die Lücken mit Annahmen. Präzise Fragen mit klarer Aufgabenstellung und der ausdrücklichen Erlaubnis, Unwissen zuzugeben, senken dieses Risiko.
2. Fehlender Kontext
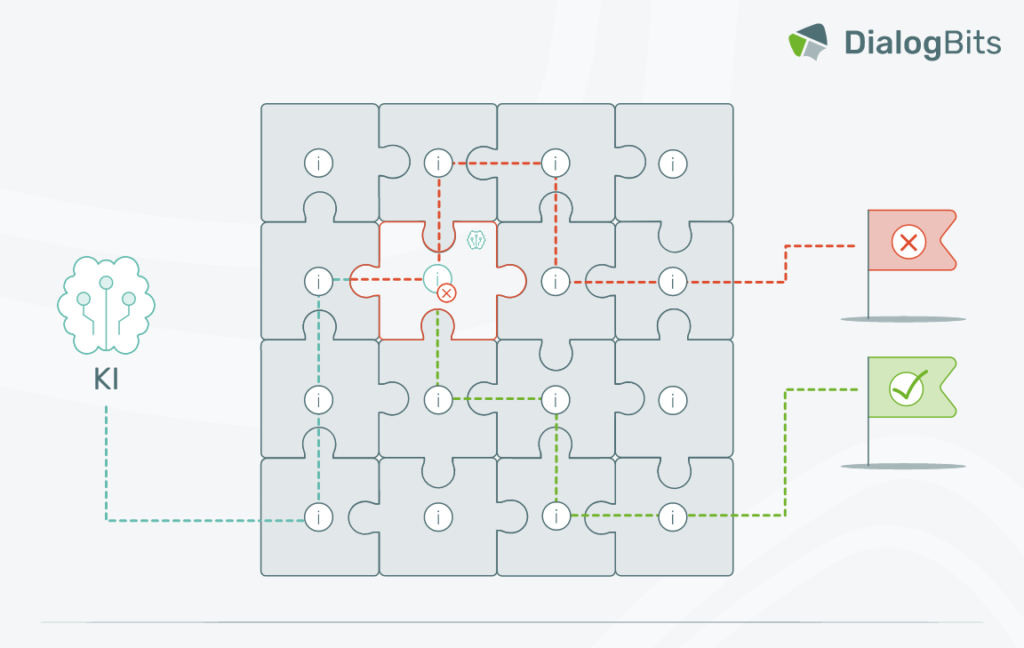
Fehlen dem Modell die relevanten Dokumente oder Daten, etwa die gültigen Vertragsbedingungen, greift es auf allgemeines Trainingswissen zurück und füllt den Rest mit plausiblen Annahmen. So ist auch die falsche Kündigungsfrist aus dem Einstieg entstanden. Hier setzt Retrieval-Augmented Generation (RAG) an und liefert passende Inhalte mit, sodass die Antworten in der Regel genauer ausfallen. Voraussetzung ist allerdings, dass die abgerufenen Inhalte stimmen und wirklich zur Frage passen.
Welche Arten von KI-Halluzinationen gibt es?
Für die Praxis lassen sich vier Hauptarten unterscheiden: faktische und kontextuelle Halluzinationen, erfundene Quellen sowie logische Halluzinationen.
Die Übersicht zeigt, wie sich die vier Arten im Alltag äußern und mit welchen Maßnahmen du ihnen begegnest:
In der Forschung, vor allem zu Zusammenfassungen und anderen quellenbasierten Aufgaben, unterscheidet man zusätzlich zwischen intrinsischen und extrinsischen Halluzinationen. Intrinsische widersprechen der vorliegenden Quelle, extrinsische fügen Informationen hinzu, die sich aus ihr weder belegen noch widerlegen lassen. Diese Unterscheidung lässt sich deshalb vor allem auf kontextuelle Halluzinationen anwenden.
Woran erkennt man KI-Halluzinationen im Arbeitsalltag?
Typische Warnsignale sind u. a. präzise Zahlen ohne Beleg, nicht auffindbare Quellen, Widersprüche im Text und selbstbewusste Antworten auf Nischenfragen.
Auf den ersten Blick sind Halluzinationen schwer zu erkennen, weil Künstliche Intelligenz Falsches genauso flüssig und überzeugend formuliert wie Richtiges. Einige typische Warnsignale helfen aber dabei, kritische Stellen zu identifizieren:
Präzise Zahlen ohne Beleg: Genaue Prozentwerte oder Daten wirken seriös, sind aber besonders fehleranfällig. Eine exakte Zahl zur KI-Nutzung im Mittelstand ohne konkrete Studie dahinter solltest du deshalb immer prüfen.
Quellen, die nicht auffindbar sind: Studien, Links oder Gesetzesparagraphen aus einer KI-Antwort lohnen immer einen kurzen Check. Wer eine Quelle trotz plausiblen Titel und Autor nirgends findet, hat es vermutlich mit einer Erfindung zu tun.
Widersprüche im Text: Steht in der Einleitung ein Budget von 50.000 € und im Fazit plötzlich 45.000 €, stimmt etwas nicht. Auch Schlussfolgerungen, die nicht zu den eigenen Aussagen passen, sind ein Warnsignal.
Inhalte, die im Original fehlen: Bei Zusammenfassungen ergänzt die KI mitunter Details, die im Ausgangsdokument gar nicht stehen, zum Beispiel eine Kündigungsfrist, die im Vertrag nicht geregelt ist.
Selbstbewusste Antworten auf Nischenfragen: Je spezieller das Thema, etwa interne Prozesse, kleinere Unternehmen oder sehr aktuelle Entwicklungen, desto eher fehlt der KI das nötige Wissen. Vorsicht ist vor allem dann geboten, wenn sie trotzdem ohne jede Einschränkung antwortet.
Prüfe Zahlen, Namen und rechtliche Angaben immer an einer unabhängigen Quelle. Bitte die KI, ihre Quellen zu nennen und Unwissen offen zuzugeben, und kontrolliere auch diese Quellen, denn sie können ebenfalls erfunden sein. Stell dieselbe Frage ruhig ein zweites Mal in anderen Worten. Unterschiedliche Antworten sind ein klares Warnsignal, übereinstimmende allerdings noch kein Beweis, denn ein Modell kann auch denselben Fehler zweimal machen. Je mehr von einer Antwort abhängt, desto wichtiger ist, dass am Ende ein Mensch draufschaut.
Warum sind KI-Halluzinationen ein Geschäftsrisiko?
KI-Halluzinationen werden zum Geschäftsrisiko, sobald sie ungeprüft bei Kundinnen und Kunden oder in Entscheidungsvorlagen landen.
- Reputationsschaden: Wer von einem KI-Agenten oder KI-Chatbot falsche Konditionen genannt bekommt, zweifelt schnell auch an allen anderen Auskünften des Unternehmens.
- Finanzielle Verluste: Fehlerhafte Berichte oder Angebote müssen nachgebessert werden. Im schlimmsten Fall wird Honorar zurückgefordert, wie der Fall Deloitte weiter unten zeigt.
- Rechtliche Risiken: Falsche Auskünfte eines KI-Chatbots können dem Unternehmen zugerechnet werden. Im Fall Moffatt v. Air Canada (2024) musste die Airline für eine falsche Tarifauskunft ihres Chatbots einstehen. Das Argument, der Chatbot sei für seine Aussagen selbst verantwortlich, ließ das zuständige Tribunal nicht gelten.
- Fehlentscheidungen: Erfundene Zahlen in einer Entscheidungsvorlage führen dazu, dass das Management auf falscher Grundlage entscheidet, oft ohne es zu merken.
Wie groß das Risiko wird, hängt vor allem davon ab, wo kontrolliert wird. Bei Berichten und Entscheidungsvorlagen ist das klar geregelt: Ein Mensch prüft, bevor etwas das Unternehmen verlässt.
Im Live-Kundendialog geht das nicht bei jeder Antwort, denn die Kundin mit der Frage nach ihrer Kündigungsfrist wartet nicht auf eine Freigabe. Dort muss die Kontrolle im System selbst liegen, etwa durch feste Quellenbindung und klare Regeln dafür, wann der KI-Chatbot besser keine Antwort gibt. Menschen kommen gezielt ins Spiel, wenn der Agent an eine Mitarbeiterin oder einen Mitarbeiter übergibt oder Antworten stichprobenartig geprüft werden.
2025 lieferte Deloitte Australia dem australischen Ministerium für Beschäftigung und Arbeitsbeziehungen (DEWR) einen Bericht im Auftragswert von rund 440.000 AUD. Später stellte sich heraus, dass er erfundene Quellenangaben und ein falsches Zitat aus einem Gerichtsurteil enthielt. Deloitte räumte den Einsatz generativer KI (Azure OpenAI GPT-4o) ein, legte eine korrigierte Fassung vor und sagte zu, die letzte Rate des Honorars zurückzuzahlen. Der Fall sorgte international für Schlagzeilen und kritische Fragen zur Qualitätssicherung.Quelle: CFO Dive [2025]
Wie lassen sich KI-Halluzinationen reduzieren? Was Unternehmen selbst tun können
KI-Halluzinationen lassen sich mit RAG, klaren Modellvorgaben, Guardrails und menschlicher Prüfung deutlich reduzieren, aber nicht vollständig ausschließen.
1. Grounding/RAG
Beim Grounding stützt sich die KI auf konkrete, verlässliche Informationsquellen statt allein auf ihr trainiertes Wissen. Retrieval-Augmented Generation (RAG) ist die bekannteste Methode dafür: Vor der Antwort werden passende Dokumente, etwa aus der unternehmensinternen Wissensdatenbank, abgerufen und als Grundlage genutzt.
2. Guardrails
Guardrails sind Schutzmechanismen, die festlegen, was eine KI darf und was nicht. Sie können etwa Antworten auf bestimmte Themen beschränken, Quellenangaben erzwingen oder Ausgaben automatisch auf Plausibilität prüfen, bevor sie bei Nutzerinnen und Nutzern ankommen.
3. Klare Modellvorgaben
Eine präzise Rolle, eine klar umrissene Aufgabe und die ausdrückliche Erlaubnis, Unwissen zuzugeben, lassen dem Modell weniger Raum zum Raten. Am besten stehen solche Vorgaben fest im Systemprompt, damit nicht jede Nutzerin und jeder Nutzer sie selbst formulieren muss.
4. Human-in-the-Loop
Hier bleibt der Mensch fester Bestandteil des Prozesses und prüft KI-Ergebnisse, bevor sie weiterverwendet werden. Bei Verträgen, Entscheidungsvorlagen und heiklen Kundenanliegen ist dieser Ansatz die wirksamste Absicherung.
Was können Modell-Anbieter gegen KI-Halluzinationen unternehmen?
Anbieter setzen vor allem beim Training an, etwa mit geprüften Daten und Verfahren, die ehrliche Antworten belohnen.
1. Datenqualität
Welche Rolle fehlerhafte Trainingsdaten spielen, ist oben unter den Ursachen beschrieben. Anbieter begegnen dem mit sorgfältig geprüften, aktuellen und widerspruchsfreien Daten. Ganz verhindern lassen sich Halluzinationen damit nicht, denn laut Kalai et al. (2025) entstehen Fehler selbst mit fehlerfreien Trainingsdaten.
2. RLHF (Reinforcement Learning from Human Feedback)
Beim RLHF bewerten Menschen die Antworten eines Modells, das daraufhin lernt, bevorzugte Antworten häufiger zu geben. Werden ehrliche Antworten belohnt, sinkt die Neigung zum Raten. Da Menschen aber oft zustimmende und selbstsicher klingende Antworten bevorzugen, kann RLHF auch dazu führen, dass Modelle Nutzern nach dem Mund reden und Unsicherheit überspielen, was KI-Halluzinationen wiederum begünstigt.
3. Fine-Tuning, das vorhandenes Wissen schont
Ein neuer Ansatz (Kaplan et al., 2026) setzt genau bei dem Problem an, das unter „Post-Training mit neuem Wissen“ beschrieben ist. Er steuert das Fine-Tuning so, dass das Modell neues Wissen erlernt und dabei möglichst wenig von seinem ursprünglichen Wissen einbüßt.
4. Ehrlichkeit in Benchmarks belohnen
Kalai et al. (2025) schlagen vor, gängige Bewertungsverfahren umzustellen: Eine falsche Antwort soll schwerer wiegen als ein ehrliches „Ich weiß es nicht“. Solange Benchmarks Raten belohnen, lohnt es sich auch für Anbieter, ihre Modelle darauf zu optimieren.
Wie reduziert DialogBits Halluzinationen in KI-Agenten?
DialogBits reduziert Halluzinationen, indem der KI-Agent nur auf freigegebene, gepflegte Wissensquellen zugreift und offen sagt, wenn die gefundenen Inhalte nicht gut genug zur Frage passen.
Einen Schalter gegen KI-Halluzinationen gibt es nicht. Mehr Verlässlichkeit entsteht erst durch das Zusammenspiel mehrerer Bausteine: eine aktuelle Wissensbasis, klare Quellenbelege und die gezielte Anweisung an das Modell, bei Unsicherheit lieber zu schweigen. Außerdem braucht es feste Regeln dafür, wie es sich in Zweifelsfällen verhält. Gelöst ist das Thema damit trotzdem nicht – denn neben sich ändernden Daten lassen sich Fehler seitens des KI-Modells nie zu 100% vermeiden. Deshalb testen wir regelmäßig und werten genau aus, was an Feedback zurückkommt.

Über 300 Sparkassen setzen DialogBits bereits ein. Die Institute beschäftigen zusammen mehr als 200.000 Mitarbeitende und betreuen rund 50 Millionen Kundinnen und Kunden. Erfahre, wie die Finanz Informatik verlässliche KI-Assistenz in einer der größten Finanzgruppen Europas umgesetzt hat.
Fazit: Mit Kontrolle zu verlässlicher KI im Unternehmen
Ganz verschwinden werden KI-Halluzinationen in Sprachmodellen (LLMs) vermutlich nicht. Wie oft sie auftreten und welchen Schaden sie anrichten, haben Unternehmen aber weitgehend selbst in der Hand. Was ein fehlender zweiter Blick kosten kann, zeigt der Fall Deloitte. Der Bericht musste korrigiert werden, Deloitte sagte die Rückzahlung eines Teils des Honorars zu, und der Fall ging international durch die Presse.
Im Kundendialog gibt es diesen zweiten Blick nicht bei jeder Antwort, deshalb muss die Absicherung dort im System liegen. Für die Kundin vom Anfang hieße das: Ein KI-Agent, der an die gültigen Vertragsbedingungen und gepflegte Unternehmensquellen gebunden ist, nennt ihr die Frist, die dort tatsächlich steht, und zeigt die Quelle dazu. Findet er nichts Passendes, sagt er das offen und übergibt an einen Menschen. So entsteht Vertrauen, bei Kundinnen und Kunden ebenso wie bei den Mitarbeitenden, die mit den Antworten arbeiten.


Du möchtest KI-Agenten einsetzen, die verlässlich auf Basis deines Unternehmenswissens antworten?
Mit DialogBits bestimmst du, auf welches Wissen dein KI-Agent zugreift. Dabei machen Quellenangaben seine Antworten überprüfbar.
Häufig gestellte Fragen zu diesem Beitrag
Nein, vollständig ausschließen lassen sie sich mit heutigen Modellen nicht. Maßnahmen wie RAG, Guardrails, Konfidenzschwellen und menschliche Prüfung reduzieren Häufigkeit und Schweregrad deutlich, ein Restrisiko bleibt aber, besonders bei sehr spezifischen oder seltenen Fragestellungen.
Ja. Wie alle Sprachmodelle kann ChatGPT falsche oder erfundene Informationen liefern, die dennoch überzeugend klingen. Neuere Versionen und die Websuche senken das Risiko, beseitigen es aber nicht.
Durch regelmäßige Tests mit typischen Fragen und passenden Kennzahlen: Die Faithfulness misst, wie genau sich Antworten an die Quellen halten, die Hallucination Rate den Anteil der Antworten mit Inhalten, die nicht durch die Quellen gedeckt sind. Nutzerfeedback ergänzt das Bild im Praxisbetrieb.
Manche KI-Agenten beantworten Fragen und führen darüber hinaus eigenständig Aktionen aus, etwa Buchungen oder Datenänderungen. Eine Halluzination wird so schnell zur falschen Handlung und kann sich über mehrere Arbeitsschritte fortsetzen. Deshalb braucht es Freigaben vor kritischen Aktionen und feste Regeln dafür, welche Werkzeuge der KI-Agent wann nutzen darf.
Je nach Modell und Aufgabe halluzinieren KI-Sprachmodelle in etwa 1,8 bis 24,2+ % der Fälle (Vectara Hallucination Leaderboard, Stand: September 2026). Das Vectara Hallucination Leaderboard misst, wie oft ein Sprachmodell beim Zusammenfassen eines Dokuments Inhalte erfindet. Für einen KI-Chatbot im eigenen Unternehmen sind das nur Richtwerte, denn dort hängt viel von Quellen und Einstellungen ab. Laut dem Phare-Benchmark spielt zudem schon die Formulierung eine Rolle. Die Anweisung, sich kurz zu fassen, verringerte bei den meisten getesteten Modelle die Widerstandsfähigkeit gegen Halluzinationen, im Extremfall um bis zu 20 Prozent (Giskard, 2025).
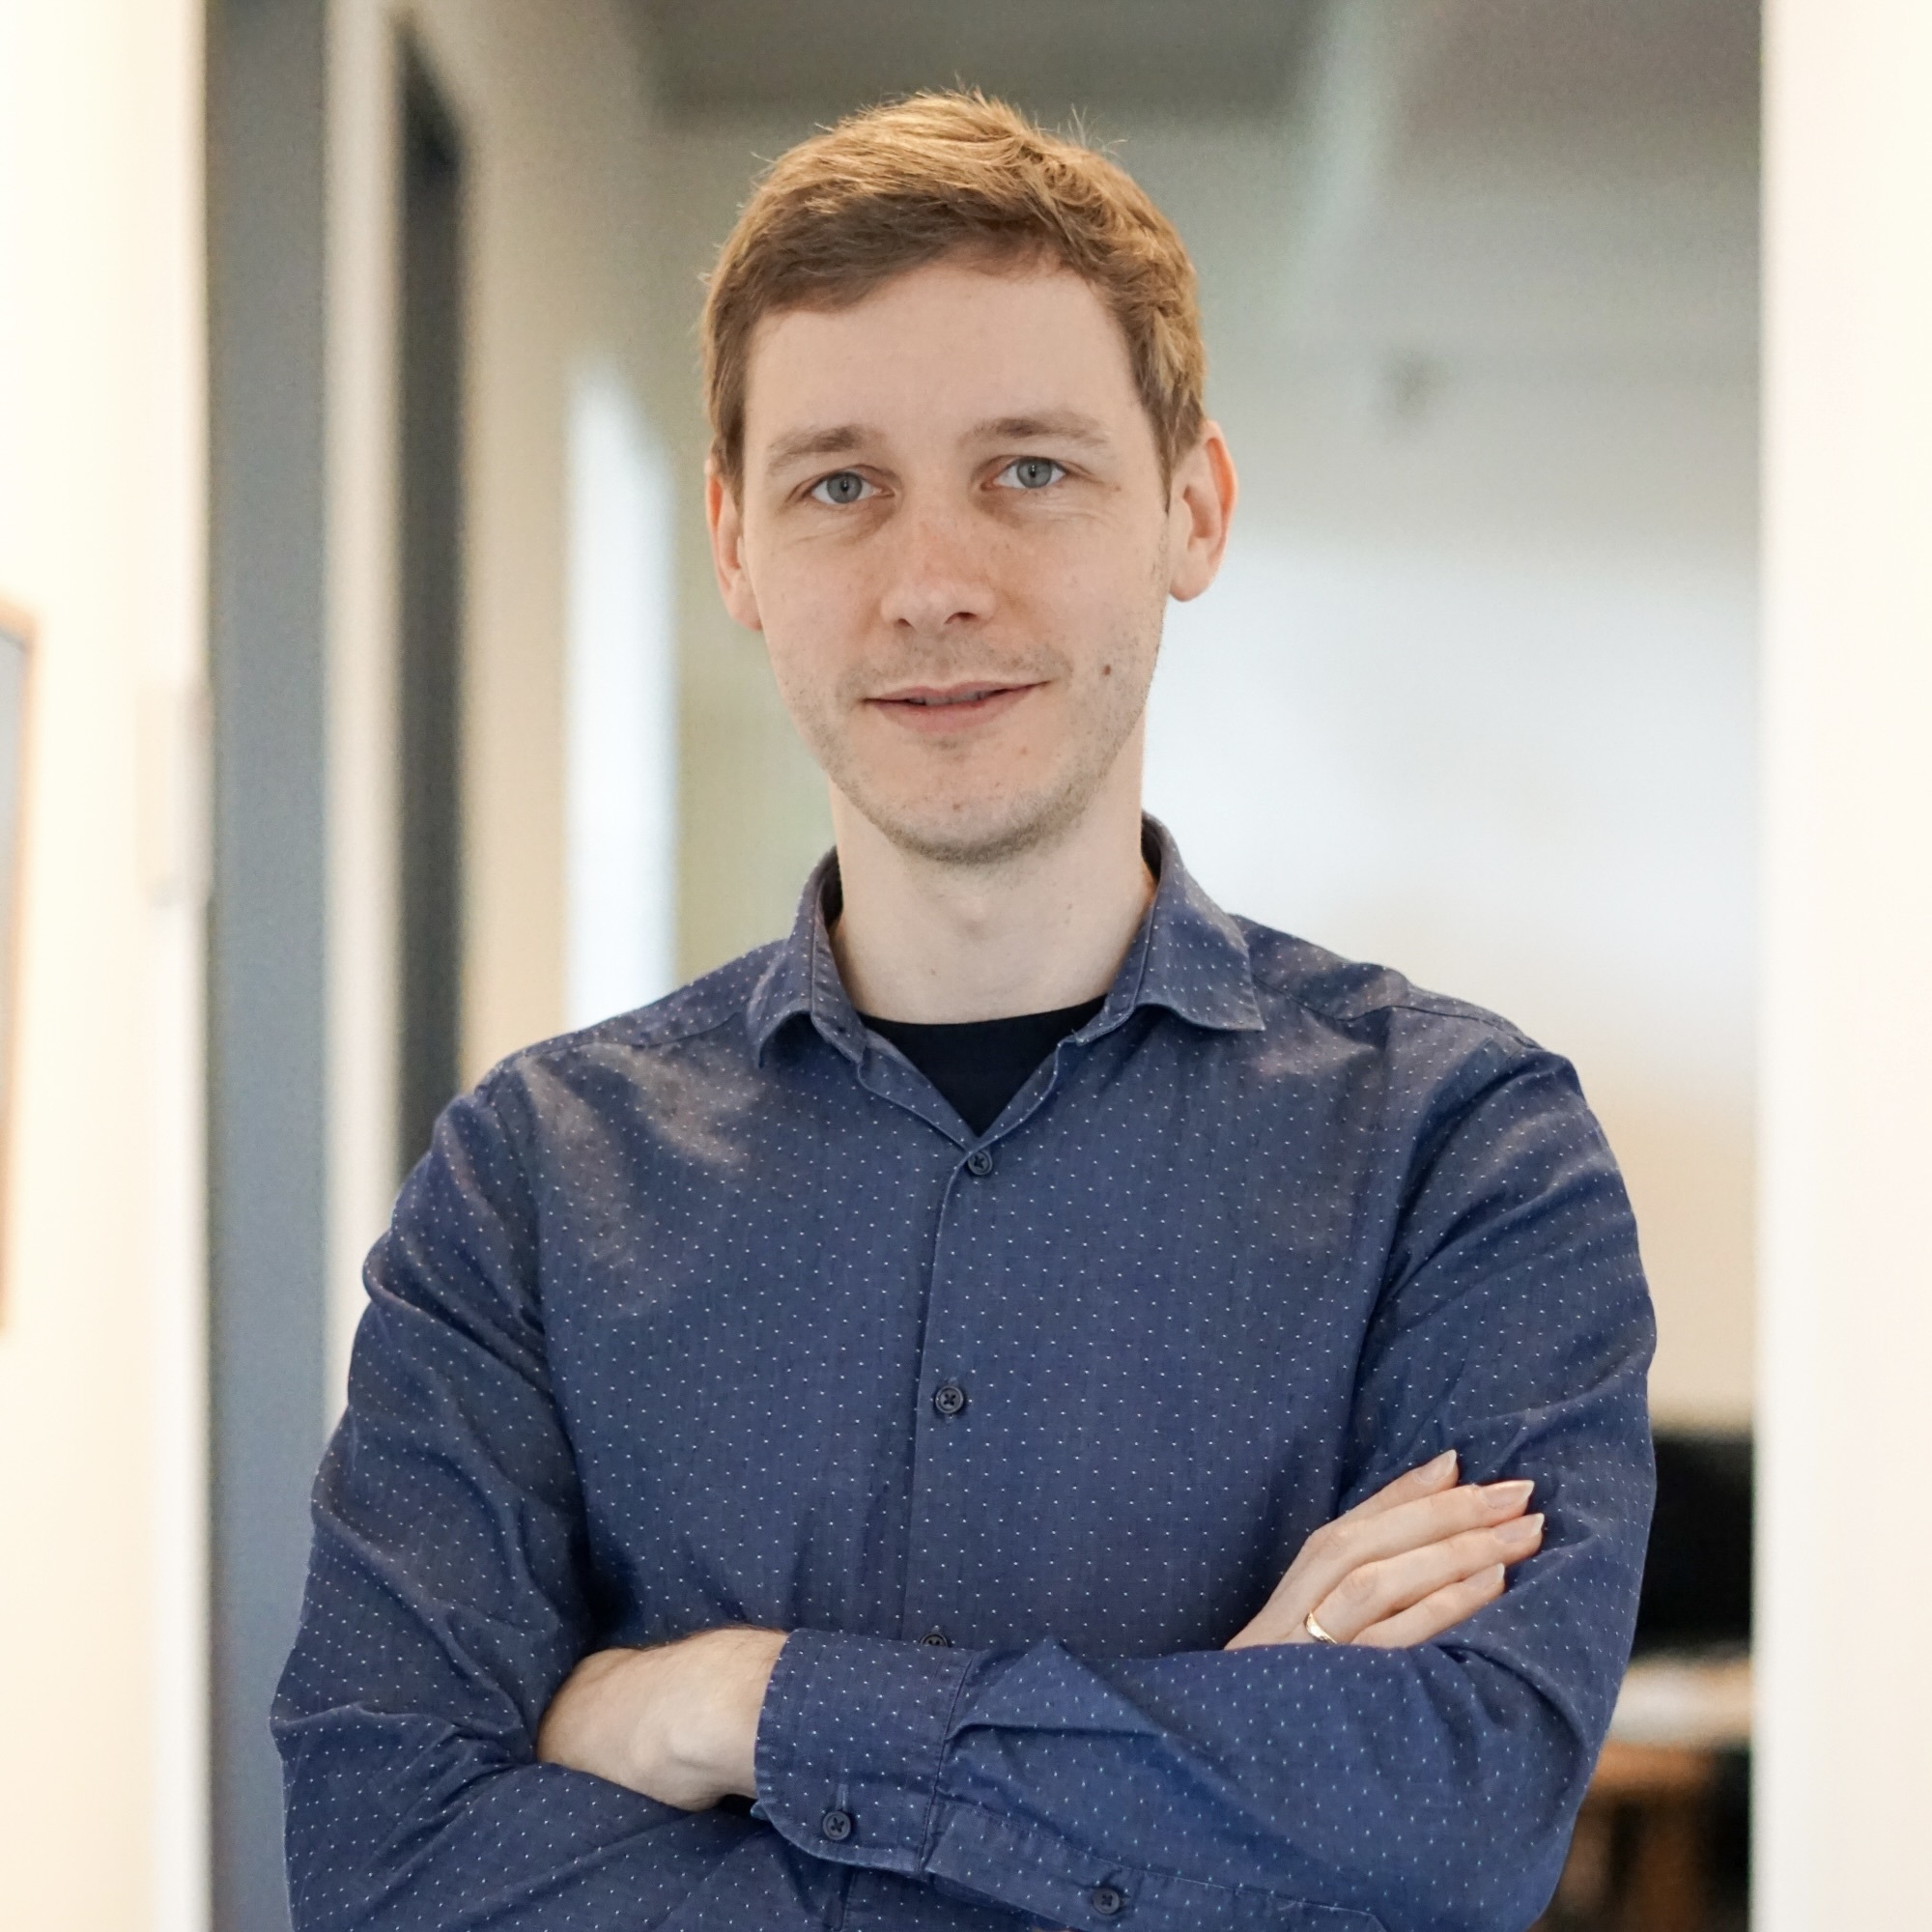
Moritz verbindet technisches Architektur-Know-how mit einem klaren Blick dafür, wie Agentic AI auch in regulierten Branchen zuverlässig funktioniert
S-KIPilot: Agentische KI für über 200.000 Mitarbeitende
Moritz ist an der Entwicklung des S-KIPilot für die Sparkassen-Finanzgruppe beteiligt. Sein Schwerpunkt liegt auf dem agentischen Framework des KI-Assistenten der Sparkassen.
Agentic AI, die in der Praxis funktioniert
Moritz übersetzt neue Agentic-AI-Konzepte in robuste Architekturen für regulierte Branchen, mit Blick auf Sicherheit, Nachvollziehbarkeit und Compliance.
Vom Profifußball zur KI-Architektur
Bevor Moritz sich der KI widmete, spielte er mehrere Jahre professionell Fußball, unter anderem für den VfL Wolfsburg und den 1. FC Magdeburg.

Web Computing GmbH
Ein Unternehmen der Sparkassen-Finanzgruppe
Wilhelm-Schickard-Straße 10
48149 Münster