Retrieval Augmented Generation: Wie RAG die Antwortqualität von KI-Chatbots und KI-Agenten steigert

Retrieval Augmented Generation (RAG) ist eine Technik, bei der vor der Antwortgenerierung gezielt relevante Informationen aus einer definierten Wissensbasis abgerufen und dem KI-Modell als Grundlage für seine Antwort bereitgestellt werden. Das reduziert Halluzinationen und macht KI-Chatbots präziser und aktueller.
Der RAG-Begriff setzt sich aus drei Bestandteilen zusammen, die den Ablauf beschreiben:
- Retrieval (Abruf): Relevante Informationen werden gezielt aus einer externen Datenquelle abgerufen. Dazu wandelt ein sogenanntes Embedding-Modell sowohl die gespeicherten Inhalte als auch die Nutzeranfrage in Vektoren um, deren Nähe zueinander die inhaltliche Ähnlichkeit abbildet.
- Augmented (erweitert): Die Anfrage wird mit den abgerufenen Informationen angereichert, das Modell erhält Wissen, das nicht in seinen Trainingsdaten steckt.
- Generation (Erzeugung): Auf Basis dieses erweiterten Kontexts erzeugt das Modell eine kohärente, faktenbasierte Antwort.
Der Ansatz ist kein ganz neues Konzept: RAG wurde erstmals 2020 von einem Forschungsteam von Facebook AI Research (heute Meta AI) beschrieben und hat sich seither als eine der gängigen Standardarchitekturen für wissensbasierte KI-Systeme etabliert.¹
Lewis et al.: „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks". Facebook AI Research, University College London und New York University, 2020 (vorveröffentlicht auf arXiv im Mai 2020, vorgestellt auf der NeurIPS 2020): die Originalpublikation, in der der Begriff „Retrieval-Augmented Generation" geprägt wurde.
Der entscheidende Unterschied zu einem klassischen Sprachmodell: Ein Standard-LLM antwortet ausschließlich aus dem, was es beim Training gelernt hat. RAG ergänzt dieses Wissen um aktuelle, unternehmensspezifische Informationen, ohne dass das Modell dafür neu trainiert werden muss.
So läuft eine RAG-Anfrage ab: vier Schritte vom Abruf bis zur Antwort
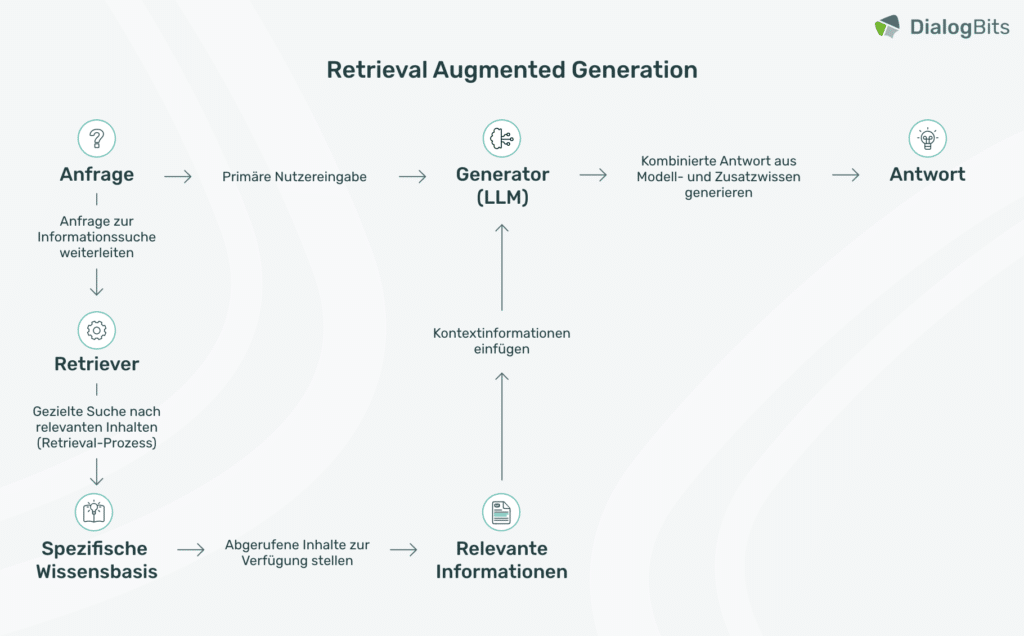
Ein RAG-System besteht aus zwei Kernkomponenten: einem Retriever, der die Wissensbasis durchsucht, und einem Generator, der aus den gefundenen Informationen eine Antwort formuliert. Dazwischen laufen vier Schritte ab:
- Datenindexierung: Dokumente werden in kleinere Abschnitte (Chunks) zerlegt, vergleichbar mit Karteikarten, die jeweils nur einen einzelnen Gedanken enthalten, und als numerische Vektoren in einer Vektordatenbank gespeichert (z. B. Elasticsearch, Pinecone, Weaviate oder pgvector).
- Datenabruf: Eine Nutzeranfrage wird ebenfalls in einen Vektor umgewandelt und per Ähnlichkeitsabgleich (häufig auf Basis der Kosinus-Ähnlichkeit) mit der Datenbank verglichen, um die relevantesten Chunks zu finden. In der Praxis kombinieren viele Systeme diesen Ähnlichkeitsabgleich zusätzlich mit klassischer Stichwortsuche, um sowohl inhaltlich passende als auch exakt benannte Treffer zuverlässig zu finden. Ein Reranking-Modell prüft die Treffer anschließend noch einmal genauer, vergleichbar mit einer zweiten Sichtung der Karteikarten, und reicht nur die passendsten weiter.
- Augmentierung: Die gefundenen Informationen werden mit der ursprünglichen Anfrage zu einem erweiterten Kontext kombiniert.
- Antwortgenerierung: Das Sprachmodell erzeugt daraus eine Antwort, häufig mit Quellenangabe, für Nachvollziehbarkeit.
In der Praxis übernehmen Orchestrierungs-Frameworks wie LangChain oder LlamaIndex viele dieser Schritte und vereinfachen den Aufbau einer eigenen RAG-Pipeline.
Nutzeranfrage: „Ist mein Vertrag noch bis Ende des Monats kündbar?"KI-Agent ohne RAG: Antwortet allgemein zu Kündigungsfristen, ohne Kenntnis der individuellen Vertragsdaten.KI-Agent mit RAG: Ruft die individuellen Vertragsdaten aus dem angebundenen System ab, beantwortet konkret mit Datum und nächstem Schritt und verweist zusätzlich auf das konkrete Vertragsdokument, aus dem die Antwort stammt, sodass sie für den Kunden nachvollziehbar bleibt.
Wie wird RAG im Unternehmen eingesetzt?
RAG eignet sich überall dort, wo KI-Chatbots auf verlässliches, aktuelles oder unternehmensspezifisches Wissen zugreifen müssen. Das zeigt sich beispielsweise in den fünf folgenden Anwendungsfällen:
- Finanzdienstleister und Sparkassen, die, wie im S-KIPilot-Projekt, Kundenanfragen zu individuellen Vertrags- oder Produktdaten automatisiert und faktenbasiert beantworten
- KI-Chatbots und KI-Agenten im Kundenservice, die produktspezifisch statt allgemein antworten
- Interne Wissensassistenten, die auf Unternehmensdokumentationen, FAQs und Richtlinien zugreifen
- Technische Dokumentation, die präzise und aktuell bleiben muss
- Suchsysteme, die Fakten mit gut formulierten Antworten verbinden
Welche Vorteile sich daraus für Unternehmen ergeben, zeigt der nächste Abschnitt.
Die fünf wichtigsten Vorteile von RAG für Unternehmen
Der Nutzen von RAG zeigt sich an mehreren Stellen zugleich: von der Aktualität des genutzten Wissens bis zur Nachvollziehbarkeit der Antworten. Fünf Stärken sind für den Unternehmenseinsatz besonders relevant:
- Aktualität: Zugriff auf aktuelle Informationen, ohne das Modell neu zu trainieren
- Präzision: Verbindet die Sprachfähigkeit großer Modelle mit verlässlichen, geprüften Daten
- Transparenz: Nachvollziehbare Quellenangaben erhöhen die Glaubwürdigkeit der Antworten
- Kosteneffizienz: Wissen lässt sich laufend erweitern, ohne die hohen Rechenkosten eines vollständigen Modelltrainings
- Skalierbarkeit: Funktioniert für kleine Wissensbasen genauso wie für umfangreiche Dokumentenbestände
Laut der Bitkom-Studie „Künstliche Intelligenz in Deutschland“ (2026; repräsentative Befragung von 604 Unternehmen) gehört KI-gestützte Wissensverwaltung neben KI-Agenten und Softwareentwicklung zu den drei am stärksten wachsenden KI-Anwendungsfeldern in deutschen Unternehmen. Das unterstreicht die praktische Relevanz von RAG für den gezielten Zugriff auf Unternehmenswissen.
Am schnellsten zeigen sich diese Vorteile, wenn Unternehmen mit einem klar abgegrenzten Anwendungsfall und einer überschaubaren Wissensbasis starten und diese schrittweise ausbauen.
RAG ist nur so gut wie die Wissensbasis, auf die es zugreift. Veraltete, widersprüchliche oder schlecht strukturierte Dokumente führen auch mit RAG zu ungenauen Antworten. Die Technologie ersetzt keine gepflegte Datengrundlage, sie macht sie erst nutzbar. Auch der Abrufschritt selbst ist keine Garantie: Wenn relevante Informationen falsch gerankt oder gar nicht gefunden werden, kann das Modell trotz RAG unvollständig oder ungenau antworten. Hinzu kommt ein oft unterschätzter Punkt: Ein RAG-System muss die bestehenden Zugriffsrechte auf Dokumentenebene abbilden, sonst könnten Mitarbeitende über Umwege Antworten aus Dokumenten erhalten, für die sie eigentlich gar nicht berechtigt sind. Wer RAG einführt, sollte deshalb zuerst in die Qualität und Struktur der eigenen Wissensquellen investieren und die Berechtigungssteuerung von Anfang an mitdenken.
Von RAG zu Agentic AI: Was KI-Agenten von KI-Chatbots unterscheidet
Ein KI-Chatbot beantwortet Fragen auf Basis von Trainingswissen, das RAG um aktuelle, unternehmensspezifische Informationen ergänzt. Im Gegensatz dazu bekommt ein KI-Agent statt einer Frage ein Ziel und arbeitet selbstständig darauf hin. Dafür plant er die nötigen Zwischenschritte und setzt Werkzeuge ein.
In der Praxis ruft ein KI-Chatbot mit RAG vor der Antwort passende Informationen aus angebundenen Wissensquellen ab, etwa aus Produktdokumentationen oder einer Wissensdatenbank. Bei gepflegten Quellen fallen die Antworten dadurch präziser und aktueller aus. Auch mit RAG bleibt ein solcher Frage-Antwort-Chatbot ein Auskunftsgeber, der Antworten liefert, aber selbst keine Aktionen anstößt. Diese Lücke schließt der KI-Agent.
Wissensabruf wie RAG kann für ihn eine Fähigkeit unter mehreren sein. Auf ein vorgegebenes Ziel hin entscheidet der KI-Agent selbst, welche Schritte nötig sind. Dafür greift er auf angebundene Systeme wie ein Ticketsystem oder einen Kalender zu. Scheitert ein Schritt, passt er sein Vorgehen an. Für diese Arbeitsweise wird häufig der Begriff Agentic AI verwendet.
Ein Kunde meldet einen beschädigten Artikel. Der KI-Chatbot erklärt ihm, wie eine Reklamation abläuft. Der KI-Agent fragt die Bestellnummer ab, legt die Reklamation als Ticket im Servicesystem an und teilt dem Kunden den nächsten Schritt mit.
Doch was passiert, wenn der Agent nicht nur auf Wissen zugreift, sondern selbst entscheidet, wann, wo und wie er es abruft?
Agentic RAG: Wenn der Abruf selbst zur Entscheidung wird
Klassische RAG-Systeme rufen Informationen einmalig ab und generieren daraus eine Antwort. Bei Agentic RAG entscheidet ein KI-Agent dagegen selbstständig, ob, wann und aus welchen Quellen er zusätzliche Informationen abruft, bei Bedarf auch in mehreren Schritten.
Stellt ein Agentic-RAG-System bei einer Kundenanfrage fest, dass die zunächst abgerufenen Vertragsdaten allein nicht ausreichen, kann es eigenständig eine zweite Abfrage starten, etwa im CRM-System, statt die Antwort mit unvollständigen Informationen zu formulieren.
Der S-KIPilot, der heute mehr als 300 Sparkassen und rund 200.000 Mitarbeitende erreicht², basiert auf einer RAG-Architektur: Das System bindet interne Dokumente, FAQs und Wissensdatenbanken an und liefert Antworten aus verifizierten, selbst kontrollierten Unternehmensquellen, nicht aus allgemeinem Trainingswissen. Weil RAG-Systeme ausschließlich auf definierte, unternehmenseigene Datenquellen zugreifen, behalten Unternehmen die volle Kontrolle darüber, welche Informationen verarbeitet werden: eine Voraussetzung, die auch zur DSGVO-konformen Umsetzung des S-KIPilot beiträgt.

Allein im S-KIPilot durchsuchen wir aktuell semantisch bereits über 100 Millionen Textpassagen. Das zeigt, in welcher Größenordnung RAG heute schon zuverlässig funktionieren muss, nicht nur bei einzelnen Dokumenten, sondern über einen enorm umfangreichen, laufend wachsenden Wissensbestand hinweg.

Damit ist Agentic RAG selbst nur ein Baustein: Das größere Bild agentischer KI-Systeme lohnt einen eigenen, tieferen Blick. Wer sich dafür interessiert, findet einen umfassenden Einblick in unserem Beitrag zu Agentic AI:
Fazit: Warum RAG die Grundlage verlässlicher KI-Chatbots und KI-Agenten ist
Am Ende bleibt ein einfacher Gedanke: RAG macht KI-Chatbots nicht klüger, sondern besser informiert, mit Wissen, das aktuell, geprüft und unternehmensspezifisch ist, ohne aufwendiges Neutraining. Für KI-Chatbots und KI-Agenten im Unternehmenseinsatz ist RAG damit die Grundlage dafür, dass Antworten überzeugend klingen und zugleich fachlich stimmen.


Du überlegst, wie RAG euren eigenen Wissensbestand nutzbar machen könnte?
Finde heraus, wie viel Potenzial in deinem Unternehmenswissen steckt. Wir zeigen dir, wo RAG den größten Hebel hat und wo ein KI-Agent sinnvoll ansetzt.
Häufig gestellte Fragen zu diesem Beitrag
Ein klassisches LLM stützt sich beim Antworten ausschließlich auf das, was während des Trainings gelernt wurde. RAG ist keine eigene KI, sondern eine Erweiterung: Es ergänzt ein bestehendes LLM um einen Abrufschritt, der aktuelles oder unternehmensspezifisches Wissen einbindet, bevor die Antwort erzeugt wird.
ChatGPT selbst ist kein reines RAG-System. Funktionen wie Web-Suche oder das Hochladen eigener Dokumente in einem Chat nutzen aber RAG-ähnliche Mechanismen: Externe Informationen werden abgerufen und in die Antwort eingebunden. Auch andere bekannte KI-Suchsysteme wie Perplexity, der KI-Modus von Google oder Microsoft Copilot setzen auf vergleichbare Mechanismen, um ihre Antworten mit aktuellen, extern abgerufenen Informationen zu untermauern.
Ja. Größere Kontextfenster erlauben zwar, mehr Text direkt in eine Anfrage zu packen, das ist aber teurer, langsamer und bei großen, sich ändernden Wissensbeständen unpraktisch. RAG bleibt der effizientere Weg, gezielt nur die relevanten Informationen abzurufen, statt bei jeder Anfrage das gesamte Wissen mitzuschicken.
Die RAG-Pipeline bezeichnet den technischen Gesamtablauf: Datenindexierung, Datenabruf, Augmentierung und Antwortgenerierung (siehe Abschnitt oben), vom Aufbau der Wissensbasis bis zur fertigen Antwort.
Fine-Tuning trainiert das Modell selbst auf neue Daten um, aufwendig, teuer und bei häufig wechselndem Wissen unpraktisch. RAG lässt das Modell unverändert und ergänzt nur den Abruf externer Informationen zur Laufzeit. Für Wissen, das sich regelmäßig ändert, ist RAG in der Regel die praktikablere Lösung.
Moritz verbindet technisches Architektur-Know-how mit einem klaren Blick dafür, wie Agentic AI auch in regulierten Branchen zuverlässig funktioniert
S-KIPilot: Agentische KI für über 200.000 Mitarbeitende
Moritz ist an der Entwicklung des S-KIPilot für die Sparkassen-Finanzgruppe beteiligt. Sein Schwerpunkt liegt auf dem agentischen Framework des KI-Assistenten der Sparkassen.
Agentic AI, die in der Praxis funktioniert
Moritz übersetzt neue Agentic-AI-Konzepte in robuste Architekturen für regulierte Branchen, mit Blick auf Sicherheit, Nachvollziehbarkeit und Compliance.
Vom Profifußball zur KI-Architektur
Bevor Moritz sich der KI widmete, spielte er mehrere Jahre professionell Fußball, unter anderem für den VfL Wolfsburg und den 1. FC Magdeburg.

Web Computing GmbH
Ein Unternehmen der Sparkassen-Finanzgruppe
Wilhelm-Schickard-Straße 10
48149 Münster